Про бенчмаркинг
TLB и большие страницы, ч. 1
Перед тем как что-то тащить в продакшн нужно как следует всё обмерить.
Даже если «настройку» советуют все вокруг. Даже если речь идет про большие страницы.
Возможно я был невнимателен, но что-то не припомню, чтобы где-то отговаривали от их внедрения. Отзывы скорее исключительно положительные.
(речь про настоящие, explicit huge pages, не THP)
Совсем свежая статья «Huge pages, TLB, and the cost of memory access» не исключение.
Вначале небольшой ликбез и бенчмарк, который показывает, что большие страницы обвалили количество промахов к dTLB с десятков миллионов до считанных тысяч и повысили скорость выполнения бенчмарка аж на 30%.
А вот это уже серьезное утверждение.
Сам бенчмарк из статьи:
int main(void) {
    char *memory = mmap(
        NULL,
        MEMORY_SIZE,
        PROT_READ | PROT_WRITE,
        MAP_PRIVATE | MAP_ANONYMOUS,
        -1,
        0
    );
    if (memory == MAP_FAILED) {
        perror("mmap");
        return 1;
    }

    // touch each page to ensure it is allocated, the first access to each page will trigger a page fault
    size_t page_count = MEMORY_SIZE / PAGE_SIZE;
    for (size_t i = 0; i < page_count; i++) {
        memory[i * PAGE_SIZE] = 1;
    }

    // visit each 4KiB page randomly, do that 100 times
    for (int j = 0; j < 100; j++) {
        for (size_t i = 0; i < page_count; i++) {
            size_t page = rand() % page_count;
            memory[page * PAGE_SIZE] += 1;
        }
    }

    printf("=== memory access completed successfully ===\n");

    munmap(memory, MEMORY_SIZE);

    return 0;
} // end of main
Версия c большими страницами различалась только дополнительными флагами к mmap для включения HP: MAP_HUGETLB | MAP_HUGE_2MB.
Замеры счетчиков и времени выполнения сделаны через perf (сокращу вывод):
perf stat -r 5 \
  -e cycles,instructions,page-faults,dTLB-loads,dTLB-load-misses \
  ./benchmark
5,353,458,005 cycles
2,869,417,305 instructions
262,200 page-faults
783,483,370 dTLB-loads
18,445,386 dTLB-load-misses
1.58942 seconds time elapsedИ сами картинки:
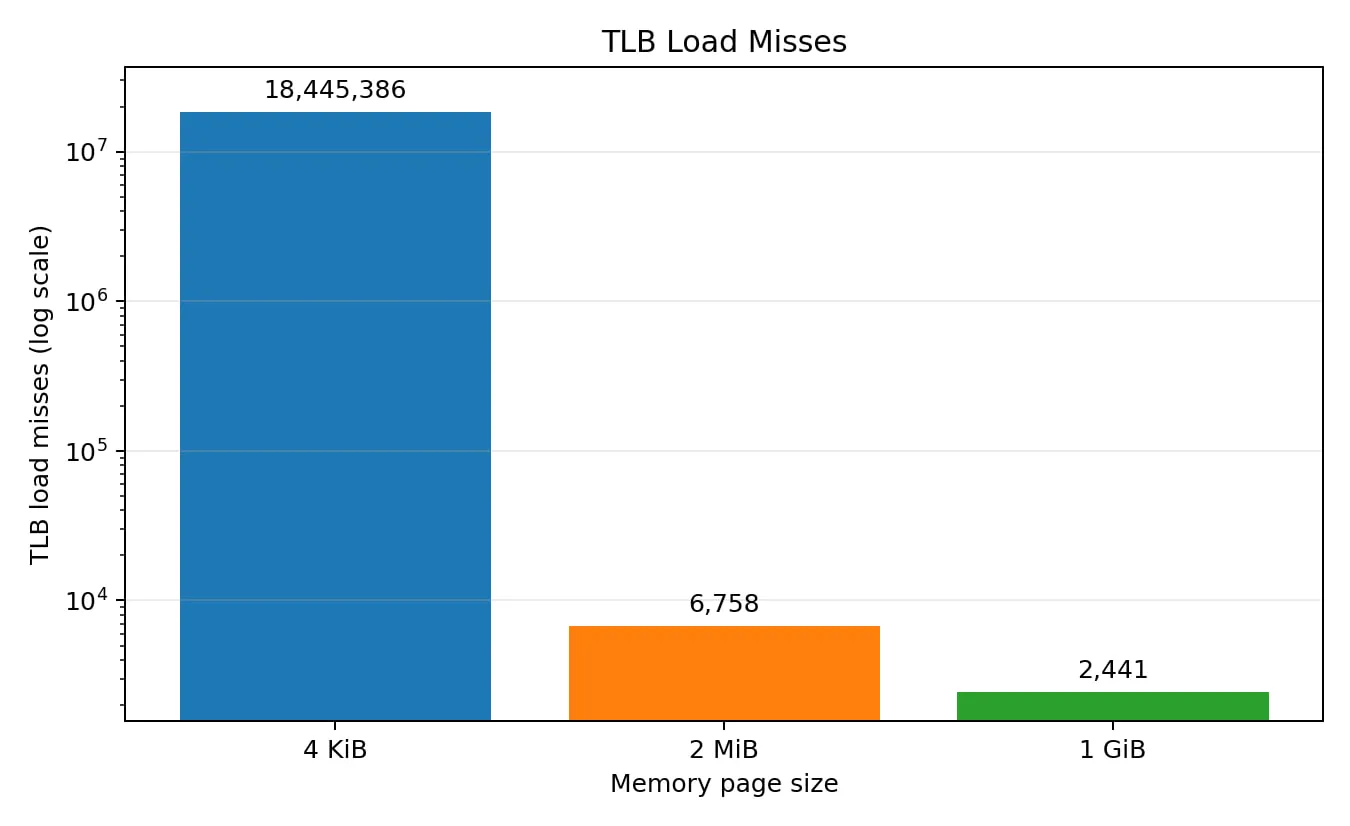
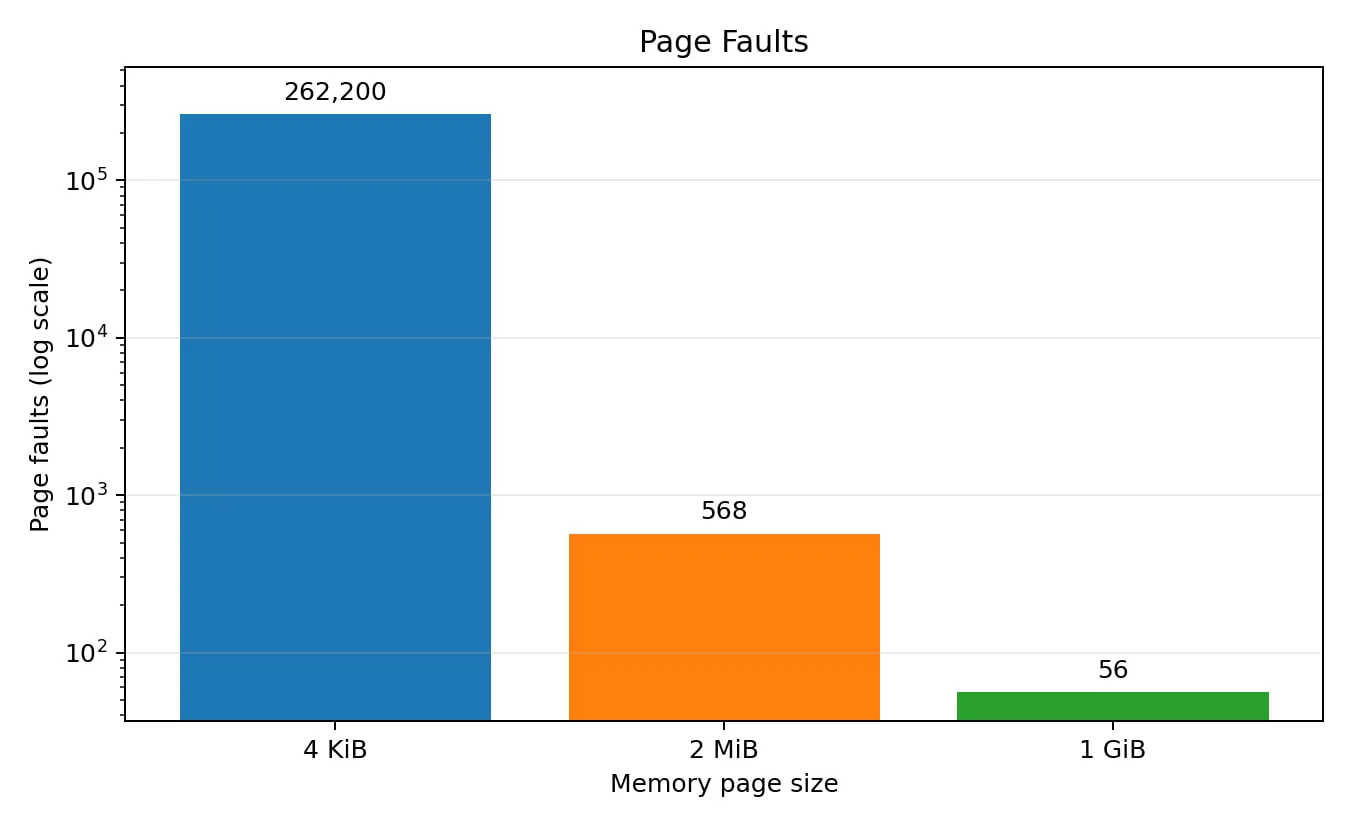
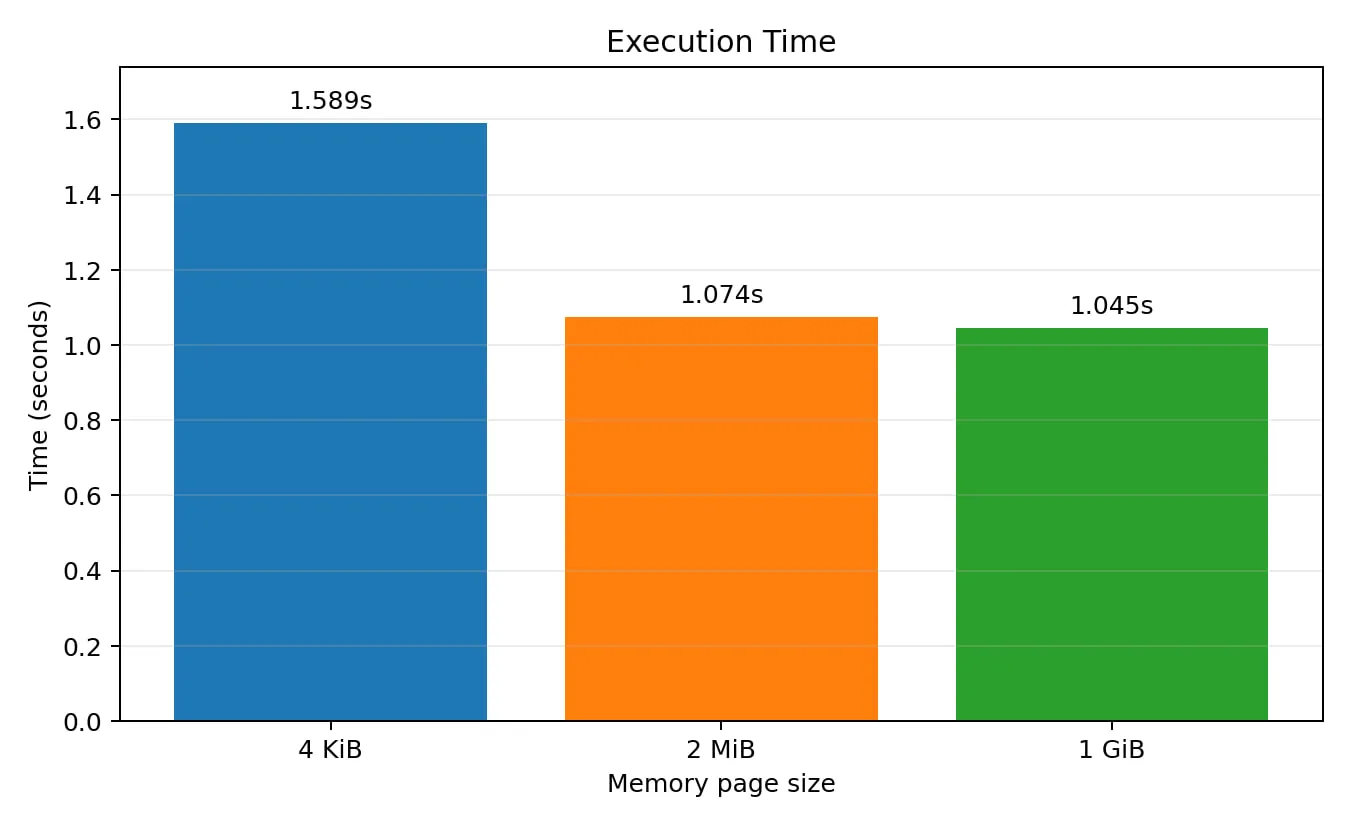
В целом можно удовлетвориться красивыми цифрами (промахи ушли, время снизилось), запомнить результаты и пойти дальше, а можно всмотреться в бенчмарк и насторожиться.
Тем более у меня был опыт, нулевого с точки зрения эффекта, внедрения больших страниц, поэтому это «дело личное».
Пожалуй главные вопросы, которые мы должны не забывать себе задавать — «а что мы хотим измерить» и «соответствует ли бенчмарк нашим целям».
Главные этапы в бенчмарке это два последовательных цикла:
- предварительное касание и заполнение страниц (тут случаются page faults)
- обход массива по случайному адресу, чтобы исключить помощь от аппаратных префетчеров и честно померять влияние от dTLB.
Но если мы хотим мерить шаг №2, то зачем нам учитывать еще и шаг №1?
Добавим пару таймштампов вокруг целевого цикла:
static double now_s(void) {
    struct timespec ts;
    clock_gettime(CLOCK_MONOTONIC, &ts);
    return ts.tv_sec + ts.tv_nsec * 1e-9;
}

int main(void) {
    ...
    double t0 = now_s();
    for (int j = 0; j < 100; j++) {
        for (size_t i = 0; i < page_count; i++) {
            ...
        }
    }
    double t1 = now_s();

    printf("Time in Loop: %.3f s\n", t1 - t0);
    ...
}
Результаты
| Page size | per iteration | vs 4K |
|---|---|---|
| 4K | 39.9 ns | |
| 2M | 37.5 ns | 6.0% |
| 1G | 38.1 ns | 4.5% |
30% ускорения схлопнулись в 4–6%. Даже немного обидно, зато честнее.
(кстати стоковый бенчмарк показал у меня +26%).
Но и 5% на дороге не валяются, верно?
Возможно, но продолжим занудство и разберемся из чего состоят эти четыре десятка наносекунд.
В теле цикла для генерации случайного числа используется rand():
...
size_t page = rand() % page_count;
...
Кто там знает как это реализовано под капотом, поэтому попросим ИИ сделать что-то подешевле, например через серию сдвигов:
static inline uint64_t xs64(uint64_t *s) {
    uint64_t x = *s;
    x ^= x << 13; x ^= x >> 7; x ^= x << 17;
    return *s = x;
}

int main(void) {
    ...
    uint64_t seed = 42;  // must be nonzero
    ...
            size_t page = xs64(&seed) % page_count;
    ...
}
Результаты
(выкину 1G страницы для упрощения)
| Page size | per iteration | vs 4K |
|---|---|---|
| 4K | 20.6 ns | |
| 2M | 20.3 ns | ~ 0.14% |
Даже 5% оказались фейком.
Но мы же видели данные из perf stat, где промахи в TLB исчислялись десятками миллионов!
Не могут же они быть бесплатными? Или могут?
Нулевой оверхед от 18 млн. TLB промахов требует объяснения.
Любая операция должна стоить времени. Вопрос лишь в том, как мы его считаем.
Упрощенно есть физическое время (wall clock), в котором мы привыкли всё мерять (например RTT соединения может составлять вполне осязаемых 250 мс) и виртуальное время, оно может совпадать с физическим, а может и нет.
Для иллюстрации:
# сжатие в один поток
$ time xz -T1 -c data.txt > /dev/null

real 0m17.959s
user 0m17.918s
sys  0m0.020s

# сжатие в два потока
$ time xz -T2 -c data.txt > /dev/null

real 0m9.440s
user 0m16.934s
sys  0m0.075s
В обоих случаях сумма user+sys time схожа: 17–18 с.
Но реальное время, или в нашей терминологии физическое, различается в два раза.
Эту концепцию можно перенести и на внутреннюю работу процессора.
Чтобы быть максимально эффективным, процессор находит независимые инструкции в потоке команд и выполняет их, часто параллельно, как только их операнды становятся доступными.
Это называется Instruction Level Parallelism (ILP).
То есть у нас одновременно могут существовать два времени:
- физическое: когда по ходу выполнения подбираемся к определенной инструкции
- виртуальное: когда процессор, забегая вперед, исполняет всё до чего получается дотянуться.
Пример с Википедии:
e = a + b
f = c + d
m = e * f
e и f не зависят друг от друга и могут быть вычислены параллельно. Конечно если их операнды доступны.
А вот m зависит и от e и от f, значит вынуждена ждать доступности их значений.
Теперь взглянем под этим углом на наш горячий цикл:
for (size_t i = 0; i < page_count; i++) {
    size_t page = xs64(&seed) % page_count;
    memory[page * PAGE_SIZE] += 1;
}
Чтобы увеличить значение в массиве в текущей итерации требуется:
- вычислить индекс
page(быстро) - загрузить значение из памяти по индексу
page(долго) - инкрементировать значение (быстро)
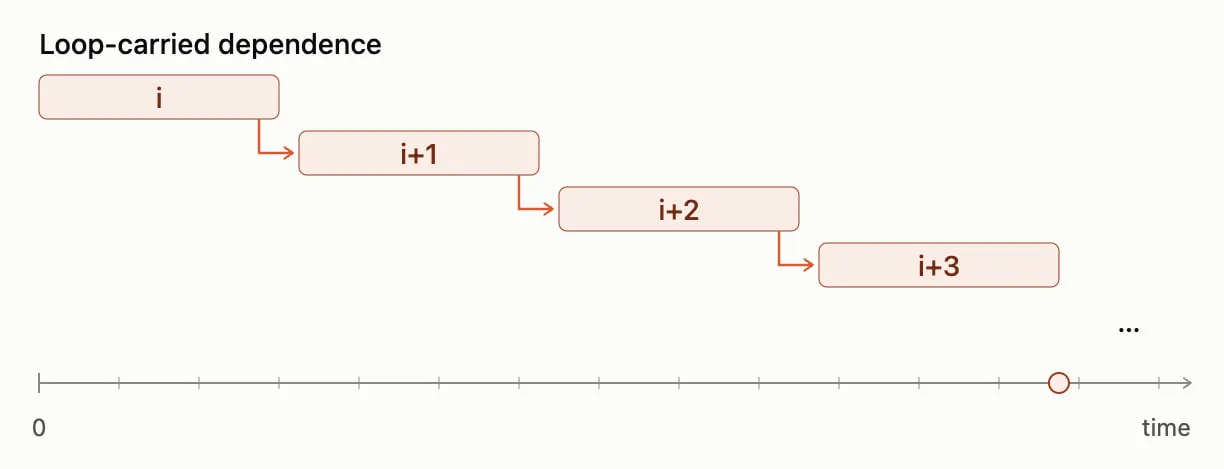
Третий шаг зависит от второго, а второй от первого. Это зависимость внутри итерации, или loop-independent dependence.
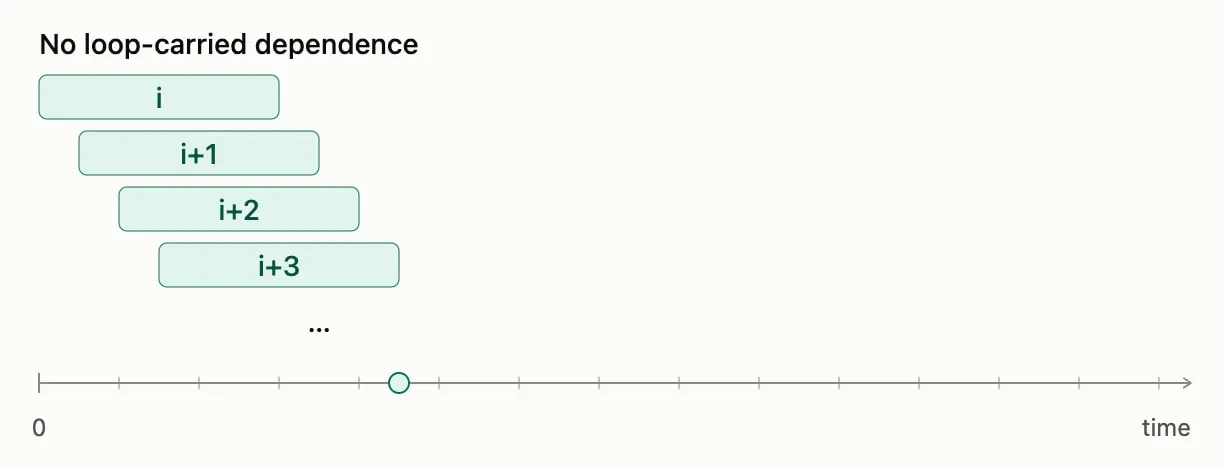
Но между итерациями зависимости через загруженное значение нет, то есть нет loop-carried dependence.
Чтобы посчитать page на итерации i+1, процессору не нужно ждать результат загрузки с итерации i. То же самое для i+2 и т.д.
Фактически процессор может бежать вперед и поджигать столько загрузок и арифметических операций, сколько будут позволять его хардварные лимиты.
И как следствие многие операции накладываются друг на друга, скрывая задержки на уровне физического времени. Хотя каждая из них в отдельности конечно стоит вполне осязаемых тактов:
Параллелизм на уровне инструкций это благо для производительности, но не для цели нашего бенчмарка. Тут ILP может ввести в заблуждение и мы сделаем неверные выводы.
И чтобы более честно померять влияние от больших страниц нам придется добавить зависимости между итерациями цикла.
Это называется Pointer Chasing:
…to be continued…